渦輪公版4/8卡RTX 5090/4090服務(wù)器工作站 AI推理與訓(xùn)練的終極解決方案
前言
在當(dāng)今人工智能技術(shù)飛速發(fā)展的時(shí)代,對(duì)大算力的需求與日俱增。無論是深度學(xué)習(xí)的模型訓(xùn)練,還是大規(guī)模推理部署,傳統(tǒng)的消費(fèi)級(jí)單卡甚至雙卡配置已經(jīng)難以滿足日益復(fù)雜的AI工作負(fù)載。為此,搭載RTX 5090或RTX 4090渦輪公版的多卡服務(wù)器和工作站應(yīng)運(yùn)而生,成為科研機(jī)構(gòu)、AI初創(chuàng)公司和大型企業(yè)部署AI基礎(chǔ)設(shè)施的熱門選擇。
為什么選擇渦輪公版?
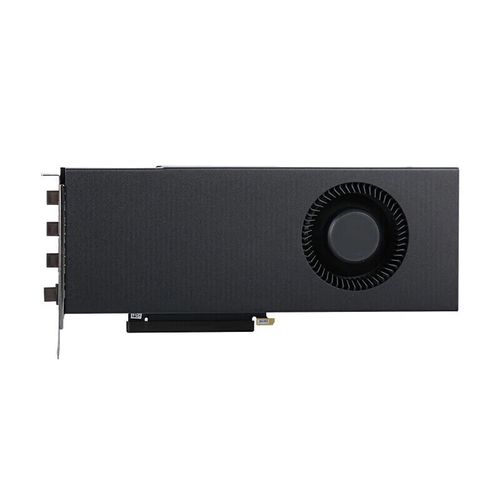
與常見的開放式散熱風(fēng)扇顯卡不同,渦輪公版顯卡采用封閉式渦輪散熱設(shè)計(jì),熱量從顯卡尾部的散熱口集中排出。這種設(shè)計(jì)在多卡并排部署時(shí)具有天然優(yōu)勢(shì):它能有效避免熱空氣在機(jī)箱內(nèi)部循環(huán)堆積,讓每張顯卡都能獲得穩(wěn)定的冷空氣,從而維持長時(shí)間高負(fù)載運(yùn)行下的性能穩(wěn)定。對(duì)于需要4卡或8卡密集部署的工作站而言,渦輪公版幾乎是必然選擇。渦輪公版通常符合更嚴(yán)格的工業(yè)標(biāo)準(zhǔn)和尺寸規(guī)范,便于在機(jī)架式服務(wù)器中密集安裝。
RTX 4090:成熟可靠的現(xiàn)役旗艦
RTX 4090基于Ada Lovelace架構(gòu),擁有16384個(gè)CUDA核心,配備24GB GDDR6X顯存,顯存位寬384-bit,帶寬高達(dá)約1TB/s。憑借其強(qiáng)大的FP16和FP8張量核心性能,單卡即可提供出色的AI訓(xùn)練和周模型推理能力。在多卡互聯(lián)方面,4090支持PCIe 4.0/5.0總線,在服務(wù)器主板上可實(shí)現(xiàn)大帶寬互聯(lián),配合定制的多卡拓?fù)潋?qū)動(dòng)方案,多卡并行效率可顯著提升。通過NVLink?實(shí)際消費(fèi)級(jí)40系并不支持NVLink,3000系才支持橋接互聯(lián),多卡通信主要依賴PCIe對(duì)于大模型訓(xùn)練中的梯度同步可以接受這在多卡8卡集群中,張量并行和流水線分布式訓(xùn)練仍然可以高效運(yùn)作,同時(shí)存儲(chǔ)從PCIe結(jié)構(gòu)還可以靈活搭配高帶寬CSD例如使用PCIe條多個(gè)高ExpressNV模型Storage固態(tài)模型輕松達(dá)到RAID配置避免Read-load i
模型效率。。本地推理可以使用GPT模型的流水線--效率可以達(dá)到理想
……
如若轉(zhuǎn)載,請(qǐng)注明出處:http://www.donghyun.cn/product/48.html
更新時(shí)間:2026-10-26 19:08:56